引言:一个看似简单却又极其困难的问题
当你将一张小狗的照片发给如今支持图片识别的人工智能时,你问他:这是什么动物,他立马会回答你:这是一只小狗。这个看似简单的识图过程,却隐藏着一个非常困难的技术挑战,语言模型本质上是一个处理文字的数学机器,他又是如何实现“看到”照片的呢?
LLM的输入是离散的符号——一串Token ID,例如:[234, 789, 1024]这样的整数序列。而一张照片却是由几十万个像素值组成的连续数字阵列。让LLM读懂照片,就如同让一个只懂盲文的人去阅读一幅画作。为实现让LLM读懂照片这一目的,需要一座极其精巧的“翻译桥梁”。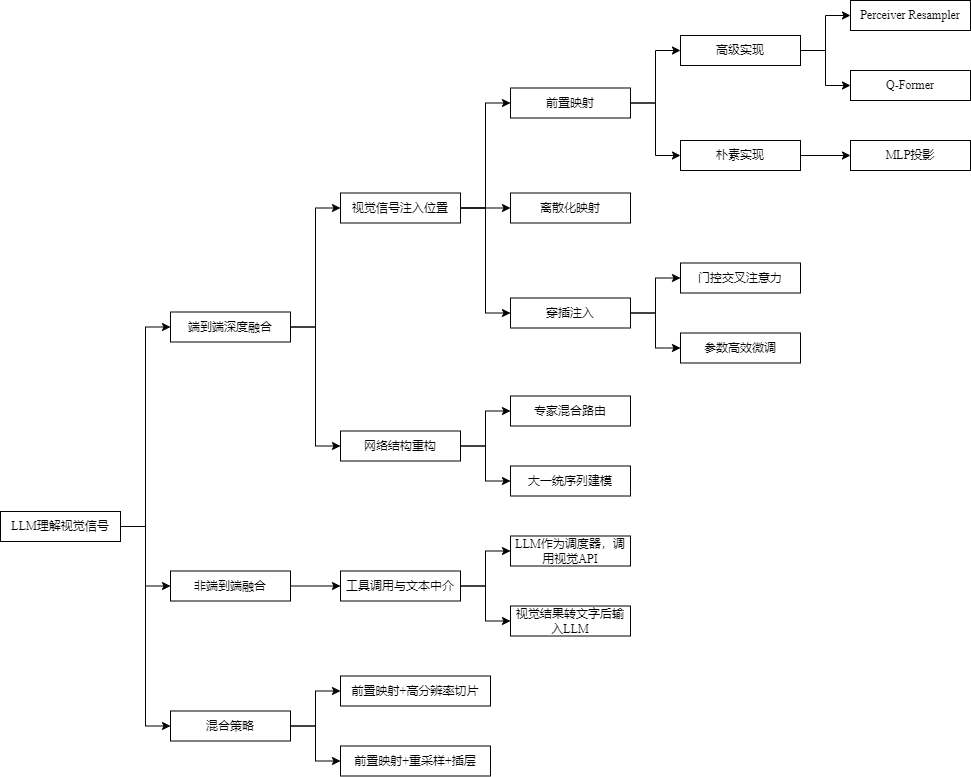
第一层分叉:两条截然不同的路线
在动手进行翻译前,研究者们首先要回答这样一个问题:我们应该把图片翻译成什么样的语言?
路线A:把图片变成“文字”,离散Token化
语言模型只认识离散的Token ID,那么如果想让LLM能够阅读图片,最直接的思路就是把图片变成一串Token ID。
具体如何实施?研究者们发明了一种叫做VQ-VAE的技术,其核心思想是建立一个视觉词汇表(Visual Codebook),其中存放着几万个“视觉单词”。然后,把图片切成小块,每一块都去词汇表中查找最相似的“视觉单词”,输出这个单词的编号。
想象一下,如果你有一本巨大的“乐高说明书”,里面收录了所有乐高积木的形状。当给你一座乐高城堡时,你将这个城堡拆成一块一块的积木,然后你记录下每块积木在说明书里的编号。最终,这个城堡就会抽象成一串编号,形如:[1024, 234, 789, ...]。
这就是DALL-E 第一代使用的方法。其优势在于:一旦图片变成了Token ID,语言模型不需要做任何结构上的修改,可以直接像处理文字一样处理图片。但这一思路也有一定的代价,离散化会丢失大量细节。比如一张照片里出现的渐变色晚霞,很难用优先的“视觉单词”精确描述。
路线B:把图片变成“向量”,连续特征映射
既然离散Token化方案有一定的损失,损失主要出在词汇表中的视觉单词量不足上,那能不能不经过“查表”这一步,直接把图片转换成一串连续的浮点数向量呢?
LLM内部处理文字时,每个Token其实也对应着一个向量(Embedding)。如果我们能把图片也映射成一组向量,而且这组向量的维度和文字Embedding的维度完全一致,那么语言模型就可以“无障碍”阅读。
这条路线绕过了视觉词汇表,因此保留的视觉信息更加丰富,目前大多数开源多模态模型都选择了这条路线,如我们熟知的LLaVA。
第二层分叉:走路线B,但具体如何走?
选择了路线B作为优选解,接下来就会面临一个问题:这些连续的向量应该放在哪里?如何让LLM读到它们?
方案1:放在句首,前置映射
最朴素的想法是:既然这些视觉向量在维度和文字Embedding一样了,那我就把它们当作“虚拟的单词”,直接拼读在文字Token前面。
比如,用户输入“请描述这张照片”,经过处理后的输入序列就变成了:
[视觉向量1, 视觉向量2, ..., 视觉向量N, 文字向量“请”, 文字向量“描述”, ...]LLM在处理这个混合序列时,会通过自注意力机制自动学会:前面的视觉向量是“图片的内容”,后面的文字是“用户的问题”。
LLaVA(原始版)就是这种方案的经典代表,他的“翻译桥梁”是一个简单的MLP,作用仅仅是将VIT输出的向量维度变换成语言模型的词嵌入维度。
但这里也存在一个问题:如果VIT输出的向量数量太多了,一张照片被切成576个小块,就会输出576个向量,直接把这576个向量塞进语言模型,会占用大量上下文窗口,导致计算量爆炸。
于是研究者们发明了“压缩器”。
方案2:压缩后再放句首,可学习查询压缩
BLIP-2中的Q-Former是这个方案的代表作,其核心创新是引入了一组可学习的“查询向量”(Queries)。
你可以将这组查询向量想象成32个记者,每个记者带着不同的任务去看图:有人的任务是观察“图中有什么物体”,有人的任务是观察“物体的颜色”,有人的任务是观察“物体的位置关系”……
这些记者,回去与VIT输出的576个图像做交叉注意力,从中提取自己需要的信息。最终,576个向量被压缩成了32个“浓缩的视觉摘要”。这32个向量既保留了关键信息,又大大节省了上下文窗口。Flamingo的视觉前端也采用了类似的思想,使用了Perceiver Resampler来完成同样的压缩任务。
方案3:穿插在视觉模型内部,交叉注意力注入
前两种方案都是把视觉向量放在句首,但Flamingo提出了一条完全不同的思路:不要放在句首,而是穿插在语言模型的每一层中间。
Flamingo的做法是:完全冻结语言模型的原始参数,然后在每隔一层的Transformer块之间,插入一个新的门控交叉注意力层。
这就如同为LLM戴上了AR眼镜,LLM在处理文字“这张图片里有什么”的过程中,每经过几层,就会“瞄一眼”旁边的图片特征,提取和自己当前计算相关的视觉信息。
Flamingo设计了一个巧妙的门控机制:新插入的层在初始化时权重几乎为零。这意味着训练刚开始时,模型的表现和纯文本语言模型完全一样。随着训练的进行,门控值逐渐打开,模型才慢慢学会利用视觉信息。这有效避免了随机初始化的视觉层导致模型“胡言乱语”的问题。
这个方案的最大优势在于:由于视觉信息是通过交叉注意力随时查询的,而不是占据上下文窗口,他适合特别处理多图对比和视频理解——你可以输入几百帧视频,而不用担心上下文被撑爆。
第三层分叉:抛开LLM的束缚,重新思考架构
前面讨论的所有方案,无论是前置映射还是穿插注入,都有一个共同前提:语言模型的主体结构保持不变。但还有一些研究者开始思考一个问题:为什么一定要将视觉通过翻译传递给语言模型?为什么不涉及一个天生就能同时处理视觉和语言的架构?
方案D:大一统序列建模
这个思路的优点是:不区分图片和文字,将其统一成同一种Token。
做法是:用VQ-VAE把图片离散化成Token ID(回到路线A),然后把图片Token和文字Token直接混合在一起,像训练纯文本GPT一样训练一个“下一Token预测”模型。
Meta的CM3Leon和苹果的4M就是这个方向的代表。在这种架构下,因为图片和文字共用同一个词汇表和同一个解码器,所以模型不仅能“看图说话”,还能“照文生图”。
这个思路达成了一个模型既能写诗,又能画画,还能看视频,与先前提到的曲线救国方案不同,这种方案真正实现了“多模态大一统”。但目前,这个方案依旧存在一个问题:离散化带来的信息损失仍然难以克服,生成高分辨率图像时容易出现细节丢失的问题。
方案E:专家混合路由
另一个思路来自MoE架构。传统的Transformer中,前馈网络是同一个网络处理所有Token。但在MoE架构中,FFN被替换成了多个专家忘了,每个Token会根据自身特性被路由到不同的专家。
如果设置一些“视觉专家”和“语言专家”,那么当视觉Token流入时,路由器会把它们导向视觉专家;当文字Token流入时,则导向语言专家。这样,视觉和语言信号就不会在同一个网络内互相干扰。MoE-LLaVA主要采用了这种方案,其优势在于:虽然模型总参数量很大,但由于稀疏激活,推理时的计算量可以显著降低。
方案F:被遗忘的曲线救国路线
在端到端方案之外,还有一条更务实的思路:既然语言模型看不懂图片,为什么不让它调用能看懂图片的工具呢?Visual ChatGPT是这条路线的最早探索者。它的做法是:给语言模型接入一组视觉工具,比如OCR文字识别、目标检测、图像分割等。当用户问“这张发票上的金额是多少”时,语言模型不会直接处理图片,而是进行以下流程:
1、判断需要调用OCR工具;
2、调用OCR工具提取图片中的文字;
3、OCR返回结果:“金额:¥1280.00”;
4、语言模型基于这个文本回答用户:发票金额是1280元。
这种方案的优势是很灵活并且可解释,可以随时给模型添加新工具,而不需要重新训练。但同时,这种方法也具有一定的代价:模型对图片的理解是间接的,无法捕捉到整体的氛围、审美或难以用语言描述的视觉信息。
目前主流模型的解决方案
行文至此,大家可能会产生一些疑惑,诸如GPT-4V、Gemini、Qwen-VL等这些顶级闭源模型,使用的是什么方案?
答案其实很简单,他们使用的方案几乎都是混合策略。
虽然这些模型的内部架构没有完全公开,但从论文、技术报告及逆向分析中可以进行推测:
- Gemini系列从一开始就是原生多模态设计,很可能结合了方案D的思路,和方案E的架构。
- GPT-4V可能采用了类似Flamingo的交叉注意力机制,同时结合了高分辨率切片技术来处理较为精细的视觉信息。
- Qwen-VL系列采用了动态分辨率策略:大图切成小块分别编码,再用重采样器压缩后送入LLM。本质上是在方案B的基础上做了工程优化。
现代多模态大模型的真实架构,往往不是某个单一方案,而是多种方案的有机融合。
从翻译走向原生
回顾整个从语言大模型到多模态大模型的进阶之路,我们可以看到一个趋势:多模态模型的演进,本质上是在从“把视觉翻译给语言模型”走向“设计一个天生就懂视觉的新架构”。
但无论技术路线如何演化,那个最初的问题始终未变:如何让机器跨越感官的界限,像人类一样自然地融合所见与所知。这条路上的每一次分叉与合流,都在向着那个目标不断迈进。
或许未来有一天,当我们再问AI你看到了什么时,它将不再需要翻译桥梁,因为它从未觉得那是一种外语。


发表评论